

阿里千问推出同声传译大模型Qwen3.8-LiveTranslate,采用Interleave架构重构实时同传,将字均延迟降至2.3秒,显著提升准确度、流畅度和简洁度。新模型支持60种语言,并增加实时说话人分离、原文译文同屏显示和长上下文消歧功能,优化听感与翻译质量。基于Hybrid MoE的Thinker-Talker双模块设计,实现流式
实时翻译的延迟再次打破了既有记录, 阿里云旗下的千通模型在今天正式公开发布。这项技术将彻底终结专业翻译人员长期占据主导地位的现状, 并使跨越语言障碍的交流活动进入到一个无须任何门槛的新阶段。
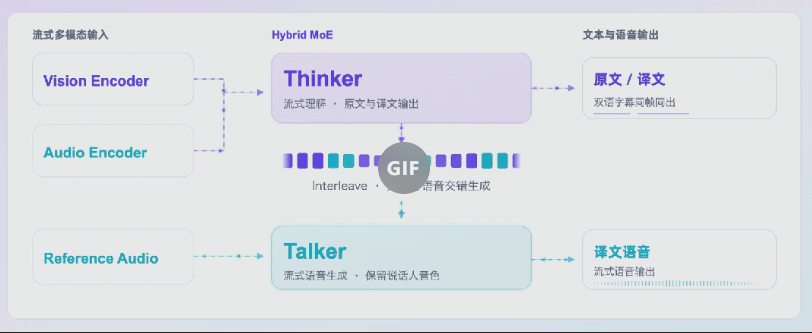
核心架构实现端到端协同
传统的同声传译设备依赖多个模块拼接, 数据在传输的途中非常容易产生累积误差, 新的模型引入了双模块的设计,它把文本输出与音频流处理整合在了同一条逻辑链里面。
利用时序交替排列机制, 把源音频还有目标译文都编码成了一个统一的序列, 因为采取了这种端到端的产出方式, 所以不光减少了中间环节产生的损耗, 还大幅度地提升了整体运算方面的效率。
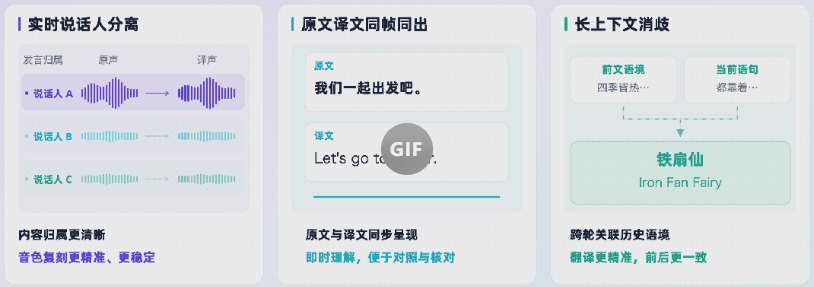
说话人分离技术迎来升级
大家以前用的那个语音识别的软件, 老是会把好几个不同的人说的话给搞混了, 这就导致了后面的内容是谁说的这一块出了特别大的乱子。这次咱们更新的这个版本里头, 专门加进了一个能实时分离说话人的新本领, 这样每一句话都能被准确无误地放回到它本来该在的那个人名下去了。
伴随着音色复刻算法实现了同步的优化, 对应的模型具备了一种能力, 就是能够非常精准地去捕捉原声所带有的那些特征, 并且把这些特征给完整地保留下来, 因此在听众接收相关信息的整个过程里面, 大家不会再出现任何担心情况, 比如说不用担心把甲的声音当成乙的声音去听, 也不用担心声音会出现串味的现象, 于是会议记录的真实度也就得到了大幅度的提升。
双语同屏显示提升对照体验
要是只是光靠耳朵去听那个翻译出来的内容的话, 那么就非常容易遗漏掉那些非常关键的细节部分, 所以呢, 视觉上的辅助手段就成了一个非常重要的刚需场景了, 新出来的系统支持那种可以把原文还有译文放在同一个画框里面显示出来, 用户啊就可以在那个大屏幕上面, 清清楚楚的看到那一边是双语对照在一起的内容。
这种设计使得参加的人可以做到在听的时候去核对, 从而非常有效地减小了信息减少的比率, 对于那些需要一遍又一遍地确认专业术语的专业地方而言, 显示在屏幕上的文字形式提供了让人放心的数据支持。
长上下文消歧增强语义理解
在进行单句翻译的时候, 如果采取孤立处理的方式, 往往会导致出现人名以及专有名词出错的状况, 造成这种结果的主要诱因就是上下文的缺失。如今机器模型已经具备了长窗口的记忆能力, 它们会主动地去关联之前的上下文语境, 从而推断出当前语句究竟是什么意思。
针对易混淆的特定词汇, 系统会结合历史对话进行动态校准。这种基于全局信息的推理机制, 使复杂场景下的翻译准确率得到实质性改善。
多语向评测数据全面领先
团队针对覆盖十四个语向的多说话人长音频数据集, 进行了严格测试。显示结果指出, 该模型在翻译忠实度、流畅度等四项核心指标上, 均超越了主流竞品。
这一情况公开了, 涉及到七十种不同语言方向的基准测试内容。这个公开行为同样起到了印证作用, 证明了存在性能优势。识别精度和合成质量这两项指标双双刷新记录。这件事证明底层的技术路线在工业化应用当中, 是具备高度可靠性的。
开放接口推动场景普惠落地
眼下那个用来抢先体验的地方, 还有那些让开发人员去接接口的手段, 都是已经正式向外面敞开大门了。不管是公司还是个人,都能够直接用这个服务。根本不需要去搭弄什么太复杂的硬件服务器, 就这么顺顺当当的把那同声传译的这个功能给接上就是了。
这项技术在过去是专门给那些高级别的会议使用的, 不过现在它正一步一步地变成一种大家都能用的基础建设。因为调用这个技术的费用变得低了, 所以在跨国界合作还有远程教育方面的那种语言障碍问题, 会被进一步去掉并消除。
您觉得这项技术最先是在跨境电商领域还是在国际会展领域产生最大的商业价值, 欢迎在下面的留言区域进行讨论, 并且请把本文中有关的内容进行分享和处理操作。

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。