

阶跃星辰发布StepAudio3系列模型,涵盖实时语音交互、语音理解、语音生成及音乐创作等场景。该系列包括StepAudio3Realtime、StepAudio3ASR、StepAudio3TTS、StepAudio3Gen和StepAudio3Music,多款模型在Artificial Analysis榜单中位列全球第一。StepAudio3Realtime支持原生全双工实时对话,语音推理准确率99.7%;StepAudio3ASR支持多语言
2026年9月16日阶跃星辰在开放平台同步上线多款语音生成理解模型, 其中核心产品在权威测试榜单得分全球第一, 其技术突破集中在实时交互及复杂场景的理解上?
本次发布涵盖了, 从语音识别对话生成至音乐创作的, 完整音频链路。公司声称这些模型在医疗、法律等专业领域表现优秀, 引发行业对语音交互的新边界的广泛关注。
实时对话技术实现全球领先
刚刚推新上线的当下同步对话模型适配原生全双工机制, 用户可在讲话之际使系统同步捕捉语义以及情绪。
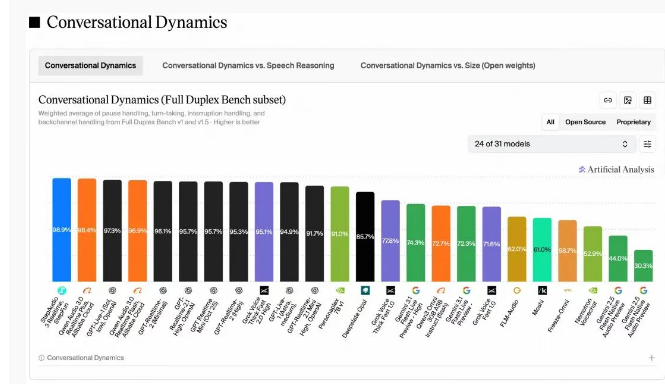
在综合测试里头, 这个模型拿下了98.9%的高分数, 排行世界第一, 意味着语音交互从单向问答转向了拟人化实时交流。
语音推理准确率刷新纪录
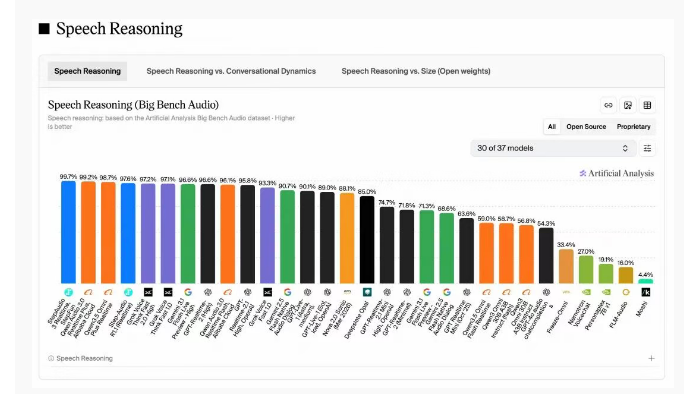
抛开交互流畅度因素, 该模型在语音推理环节的具体表现也尤为鲜明优异, 其准确率高达百分之九十九点七的具体占比情况之下, 同样可以直接划归到全球第一的具体行列之中。
这项数据反映模型不单能掌握语面含义, 还可准确抓准语调、副言语及声场杂声里的内层信息, 很强改善了理解健壮性。
多方言识别能力全面覆盖
另一款识别模型融合了大模型上下文理解能力, 支持中文、多类方言及英文来的混合输入场景。
其字符的错误率仅为百分之一点七, 与全球最低水平完全并列, 尤其针对医疗还有金融之类的专业范畴的长音频转录, 实施了更深度的优化处理。
副语言表现力显著提升
专注于生成模型强化了的是音色内语调中及如停顿一类细节, 甚至能够模拟在笑声、迟疑等外还有结巴等自然表现出来之类的反应。
这种副语言的精细化精细控制让大段连续语境下的真人式语音输出更完整, 支持符合不同场景的响应式流式响应生成, 契合用户对低延迟高保真语音交互的深度预期。
多模态音频生成能力拓展
新发布的生模型成模型能统够一处的理处角色人声、音效和音乐背背景音, 并支时持多角色序控时制序。
使用者凭借自然语言命令, 对曲风、旋律及乐器实施调置, 达成由清唱配伴奏直至成品翻唱的全步音乐内容自动成产。
平台生态完善降低门槛
如今推出的全部五款模型都均已接入阶跃星辰开放平台, 开发者能够径直调用整套音频生成操作与智能会话交流能力。
这种一站式服务降低了集成复杂度, 语音应用开发从单一功能模块扩展至全流程内容创作成为现实。
你感到现在的语音模型距离切实替代真人的主播或者客服, 到底还有多久? 欢迎在这些大家发表留言的专区聊聊你的见解, 点赞而且分享给同样在意智能交互技术进展的伙伴们。

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。