

DeepSeek-V4-Flash-Vision-Exp 是 V4 家族首款实验性多模态模型,参数量达 305B,基于 V4-Flash-0731 并接入视觉编码器和 Aligner,具备图像理解能力。该模型不主打视觉问答,而是专注于多模态 Agent 能力,让 Agent 直接读取网页截图、软件界面等视觉信息并执行任务。开源内容完整,包括模型权重、Tokenizer 等,社区反响积极。
新动态在AI圈出现了, Face正式发布了V4-Flash-Exp, 它属于V4家族首款实验性多模态模型, 直接和热门的闭源多模态Agent产品在市场上形成对标。
此模型以开源的方式采用了MIT协议, 这就表明开发者能够将其免费应用于商业项目之中。官方所给出的定位颇为明晰, 那便是不从事视觉问答方面的工作, 而是专心致力于多模态Agent场景之内。
全新赛道定位
之前的常规多模样版式模型重点处理的是参照图片进行话语表述这类问题, 然而Face这回选取开展了一条不一样的技术方式路径。官方清楚明晰表达说明白了, 该个新出炉版本里边最为举足轻重关键主打的本事能力素质本领是多模样式Agent, 并非仅仅只是简单纯粹的图像识别功能。
那就是说, 模型所针对的目标用户, 乃是那些有着让AI直接去操作软件需求的开发者。模型具备读取网页截图、软件界面、图表等视觉信息的能力, 并且能结合工具调用, 进而完成复杂任务流程。
完整开源内容
针对此次开源包, 其覆盖了完整的技术栈, 其中有模型权重, 还有配置文件, 另外包含参考实现代码, 以及一份最小化推理实现方案。此次开源范围涉及视觉编码器, 涉及MoE架构, 涉及Hyper参数设置等核心模块。
社区作出的反应颇为快速, 在Face页面这一地方, 已然呈现出有7个针对不同框架的量化版本的情况。这些版本, 各自与llama.cpp相互适配, 与LM相互适配, 还与GPTQ等平台相互适配, 以此方便对应不同技术背景的开发者去进行使用。
分阶段发布策略
细节于时间线上颇值得予以关注, 该模型于8月21日借助API登场上线之时仅仅开放了调用功能而并未施行权重下载, 开发者能够凭借API一并将文字与图片予以输入, 其中图片部分乃是按照Token来计费的。
这个模型的权重, 要到十天之后的8月31日, 才会正式开放。这样一种节奏安排, 显示出Face这家公司对于这个模型, 有着清晰明确的商业化规划, 并且还留出了本地部署以及二次开发的可能性存在。
基准测试表现
加入视觉能力之后, 纯文本Agent能力出现了提升, 这是由性能数据所显示的。Bench 2.1评分从82.7提升到了83.9, MBPP评分呢从54.4提升到了59.3, 超过了Opus 4.8的58.0分, 这就是后者的情况。
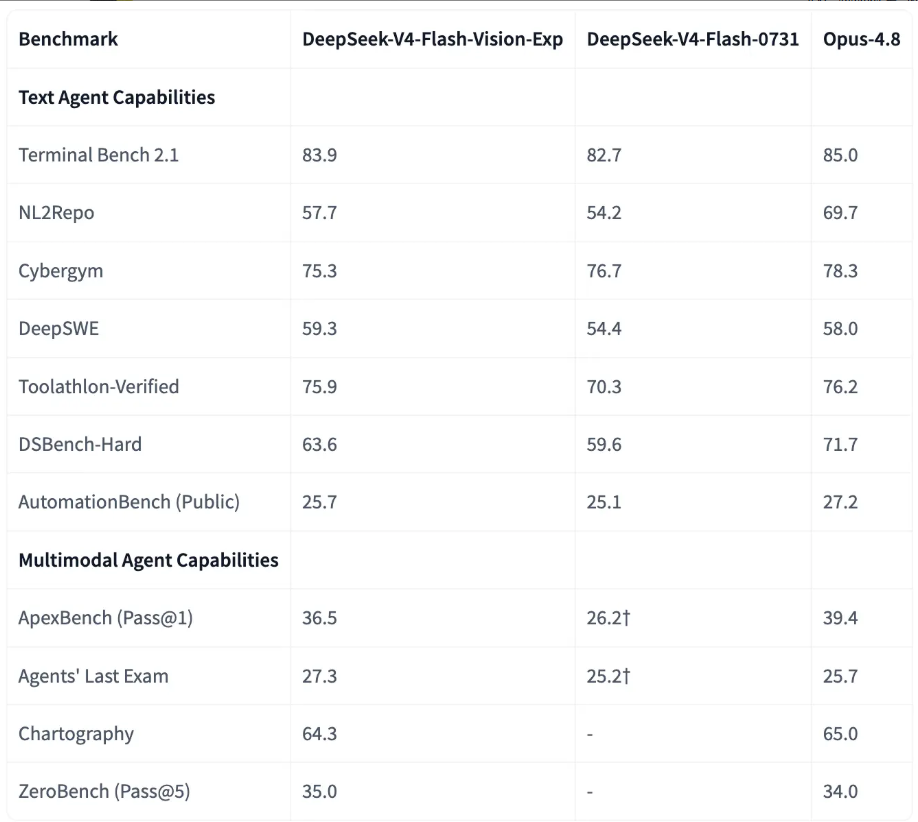
专项测试结果里, 多模态Agent更为突出, MVPass@1达到36.5, LiveExam以27.3分超过Opus 4.8的25.7分, MVPass@5也以35.0分压过对手的34.0分。
官方措辞克制
纵使多项指标呈现出优异的表现, Face却并未宣称在各个方面都超越了竞争对手。在MMLU – Pro项目当中, 它所获得的分数是57.7, 而Opus 4.8的分数是69.7, 二者之间存在着显著的差距。官方的表述一直秉持谨慎的态度, 仅仅声称多模态Agent能力接近于Opus 4.8的水平。
此种克制表现, 反映出开源模型碰到闭源强劲对手之际的务实型定位, 官方更加趋向于着重突出特定场景当中的竞争力, 并非一概而论的综合性评判。
完整技术栈拼图
连贯着去看近期所进行的更新, Face正着手搭建一套体系完整的Agent技术体系 , 核心模型承担着推理以及工具调用的职责 , 持续实现任务的执行 , 此次予以开源的多模态版本使得Agent能够径直读取电脑视觉信息。
这一策略明确地朝着一个目标去指向, 那就是, 打造出从感知一直到执行的端到端的Agent解决方案。305B参数规模的V4 – Flash – Exp恰恰就是这块起着关键作用的拼图。
你认为, 这般先将API予以开放, 而后再进行开源的模式, 针对行业竞争格局而言, 会产生怎样的影响? 欢迎于评论区去分享你的看法, 并且也千万别忘记, 要对本文予以点赞以及转发。

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。