

新一代同传大模型Qwen3.8-LiveTranslate全面升级,延迟降至2.3秒。新增实时说话人分离、原文译文同帧同出、长上下文消歧能力,语音保留原音色。采用Hybrid MoE双模块设计,在多说话人评测中表现优异。支持60种语言,API已上线。下一步将聚焦时延压缩、长期记忆和更多语种。
字均延迟从原来的2.8秒压缩到了现在的2.3秒, 同时译文语音还能够稳定地复刻, 也就是模拟出, 那个原说话人自己的音色特点, 像这样新一代的同传, 翻译用的, 大型模型Qwen3.8是在2026年9月这个时间点正式发布的, 它对四个维度进行了同步的、一起的升级, 这一举动引发了实时翻译行业的广泛关注。
架构整合与延迟突破
Qwen3.8采用了音频和文本相互交错的因果序列架构。它将流式的理解, 把文本的输出, 还有语音的生成, 整合到了同一条处理链路里去了。这样一来, 它就不再需要那种多个模块之间串联来传递信息的老办法了。
这个设计让每个字的延迟降到了 2.3 秒, 比上一代的 2.8 秒还要短一些, 所以在多个说话人一起讲话的场景下, 响应速度提高了大约百分之十八, 这基本上是可以满足会议级别的实时同声传译需求的。
说话人分离与音色保留
新增了可以实时分辨说话人的模块, 当有好几个人你一句我一句轮流讲话的时候, 这个模块能够逐句识别出每一句话是谁说的, 这就能有效地避开译文里面人物弄混, 出现串人这种情况的问题。
合成的语音这种技术, 能够稳定地把原说话人的音色特征给保留下来。这就让在双语同传会议当中, 每一位发言者的那种声音的身份, 得到了维持和保持。
双语同帧同步显示
原文的内容以及与它对应的翻译内容实现在同一个时间节点上同时出现, 在屏幕这一区域之上, 中文还有外文进行同步的流动展示, 使得参与参会的各位人士不需要处在等待翻译完成和回头去审视原版文字这个两个状态之间来频繁地来回切换操作过程。
这个功能对于需要进行技术评审的情况来说, 是非常实用的。同时, 它在法律文件解读等方面也表现得非常出色。因为这些场景都需要人们去即时核对原文内容。在这样的情况下使用这个功能, 能够使得信息获取的效率得到明显的提升。
长上下文消歧机制
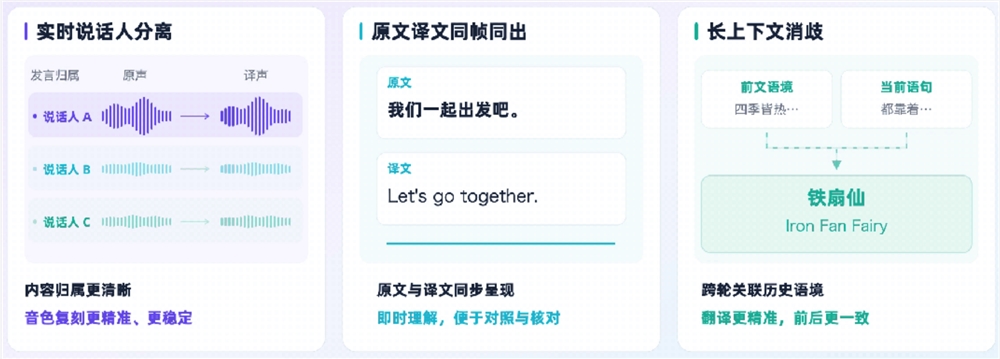
这个模型借助于跨度的轮次去关联起历史语境, 针对专有名词或者是像指代词这样的高频歧义源, 进行上下文锁定, 以此减少误译的发生。
在进行那种时间很长、问答轮次很多的会议场景时, 翻译的一致性得到了极为明显的改善, 对于同一个术语, 它在前面说过的内容和后面再次提到时的表述, 再也不会出现互相矛盾或者前后不一的情况了。
MoE双模块评测表现
该模型采用了一种在MoE架构之下的设计方案, 这里包含了理解与合成这两个模块。前半部分的作用是对内容进行翻译和理解, 而后半部分则会生成译文语音, 这种生成的方式能够保留原本的声音音色。
这个评测集涵盖了14个语向, 并且包含多说话人的长音频。在这些测试中, 翻译的忠实度、流畅度、简洁度, 以及说话人分离错误率这四项指标, 均比当前主流实时同传系统的表现要好。
多语言支持与后续规划
现在的Qwen3.8目前已经支持了60种语言, API也已经同步上线到了千问AI平台, 所以开发者可以直接调用接口来进行集成操作。
团队这边的意思是说, 接下来的步骤, 要把重心放在两个方面。一个是去压缩端到端的时候的那个延迟, 尽量把它降到最小。还有一个是去搞跨会话的长期记忆功能。再有就是会去覆盖更多的语言种类, 具体的目标, 是让语言的数量扩展到超过八十种。
你觉得2.3秒这个延迟的时间长度, 它到底够不够那个所谓的真正的实时状态? 你可以去评论区里聊一聊你在同传的体验方面有什么样的期待。要是觉得这段内容有用的话,那就点击一下点赞按钮, 然后把这篇帖子分享出去给更多人知道。

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。