

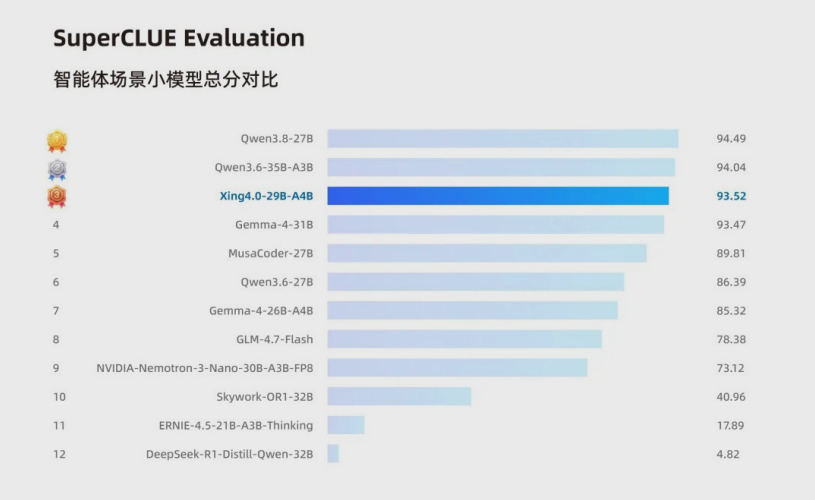
中国电信推出百亿参数大模型Xing4.0-29B-A4B,总参数29B,激活参数仅4B,支持256K至512K上下文。该模型是首个全栈国产的百亿参数大模型,采用昇腾芯片训练,国产框架适配,架构自研且生态开源,实现全链路自主可控。在SuperCLUE评测中,智能体能力得分93.52,位列第三。此外,
在9月17日这一天, 中国电信正式发布了星辰大模型Xing4.0-29B-A4B, 这款模型的总参数量达到了29B, 不过实际被激活的参数量仅有4B, 当采用4-bit量化处理方式之后, 只需要15GB的显存空间就可以在本机设备上完成运行操作了, 从这一点来看, 这是在国内范围内首个实现了从开始训练时所依赖的芯片硬件一直到最后进行推理并部署应用的整个全链条过程都完全使用国产化技术和产品的符合百亿参数规模的大型语言智能系统。
全栈国产闭环
昇腾芯片承担了训练的活儿, 国产框架完成了适配。架构是搞的自研设计, 在生态层面一直坚持开源和开放。从下面的算力到上面的工具链, 整条链路都不依靠海外的供应链。
眼下算力这个环节老是让人头疼, 经常被卡住脖子。官方就想了个办法, 把模型训练、拿来推理还有最后部署这三件事儿紧紧抱成一团, 搞成了一个完整的闭环方案。他们着重强调了一句话, 就是说不管哪一个单独的阶段出了岔子, 都别想影响模型的最终交付和后续迭代。总之, 得保证整体进程不受单点问题的干扰。
参数与上下文规格
这个模型的总的参数数量达到了290亿, 其中被激活的参数数量为40亿, 并且采用了基于稀疏门控的混合专家架构进行设计。
它在原生状态下就已经支持长度为256K token上下文窗口的处理能力, 如果经过进一步的扩展操作的话还可以把这一上限提升到了512K, 这样的性能表现是专门针对超长文本阅读需求以及高复杂度的工程技术性工作任务场景而打造出来的。
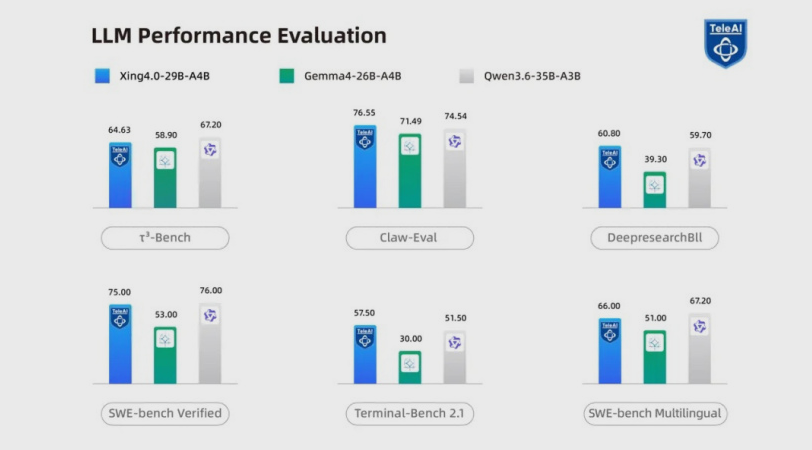
所谓4B的激活, 其实就是指在推理的时候, 实际算起来的计算量, 大概和小模型差不多。同时呢, 29B这个总参数量, 它是保留了足够多的知识容量的。这样一来的话, 就是在速度和深度之间, 拿到了一个平衡。
智能体评测成绩
在官方开展的评测工作里面, Xing4.0-29B-A4B这个智能体所获得的能力方面的得分达到了九十三点五二分, 它的排名位于第三位, 它与排在第一位和排在第二位的属于Qwen系列的头部模型之间的分数差距, 都没有超过一分。
这一结果表明, 轻量级国产模型在复杂的工程任务方面已经非常接近第一梯队的水平, 而两者之间的差距主要是集中在需要多个步骤的规划以及工具使用调用这样的环节上面。
量化显存门槛
在经过了4-bit量化处理以后, 模型的显存占用情况变成了15GB。这种变化让FP16格式的显存消耗节省了大约75%。因为这样, 如果有一张配备24GB显存的消费级显卡的话, 就可以在本地环境里面完成针对256K长上下文的推理任务了。
个人开发者以及中小团队, 完全不用去租赁云服务器, 也根本不需要堆积使用多显卡, 只要拥有一台工作站, 就能够把长文档分析、代码生成这些工程场景跑起来。
开源生态适配
在微调这一侧, 它支持像LLaMA-Factory这类主流工具。在推理这一侧, 它去适配transformers、vLLM等框架。在Agent层, 它针对LangChain及Code Interpreter, 做了定向格式对齐的动作。
目前, 这些权重已经先后在Hugging Face、ModelScope、Gitee还有魔乐社区这些地方上线了。开发人员在拿到这些重量级的模型参数文件之后, 可以直接把它们下载下来使用。
接下来就完全可以对这些模型进行微调处理, 或者是直接进行部署工作。在这个过程当中, 你根本就不用再去额外申请任何额外的授权许可。
行业影响与竞争格局
把“全栈国产”这四个字写进产品定义里面, 它这个意义, 那可是超出了单纯的参数比赛本身。那些中小规模的团队, 也得到了一个门槛比较低的选择, 就是用国产的这些方案。然后, 关于算力供应链存在的那些风险, 也被十分显著地给压缩了不少。
下一个阶段的市场关注点会落在512K扩展上下文的实际推理速度上面, 这一点是需要重点观察的, 另外还有国产推理框架在大规模并发场景下的吞吐表现情况, 这些内容也会受到市场的密切注视。
你是不是打算用那些拥有15GB显存、安装在本地的电脑设备, 去运行星辰这一款大型模型来开展日常的开发工作呢? 非常希望大家能够来到评论区域当中, 去讨论并且分享你们各自的想法。如果觉得有价值就点赞并转发的行为多做一点, 让拥有更多人数量的旁观者能够看见到这些内容信息。

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。