

生数科技发布全新Vidu S2视频大模型系列,包含Vidu S2-Avatar和Vidu S2-Editing两大核心模型。Vidu S2-Avatar支持语音和文本持续交互,可动态调整角色动作、服装和场景,并提升输出分辨率至720P;Vidu S2-Editing则能实时编辑输入视频流。此外,公司还探索了面向VR头显的实时空间视频生成
在9月15日, 生数科技推出的视频大模型新系列终于正式现身了, 而且这一系列的诸多核心功能能力, 已经刷新了在行业里的那种实时生成编辑的体验情况。
新品发布基本概况
核心模型组成架构
这次发布的Vidu S2系列里面有两只最核心的模型, 它们一个是为了能让持续互动的数字角色被制造出来而存在的, 另一个则是为了适应那种对实时视频流进行编辑的应用环境而被设计出来的。
整个项目从开始研究到最终完成的全套链条, 都是由朱军教授的博士生张金涛主导搞定的, 他现在的身份是生数科技里负责流式视频生成以及推理工作的负责人。
这两款模型分别覆盖了不同的细分应用需求, 并且, 与此同时, 生数科技也同步启动了技术探索工作, 所探索的技术是面向 VR 头显的实时空间视频生成编辑技术, 此举拓展了元宇宙内容生产的新路径。
发布时间与参与主体
本次新品的正式发布时间定在了2026年9月15日这一天。生数科技是属于那种在国内很专注流式视频生成的这样一个AI企业, 他们把核心技术团队全部都集结在了一起, 最终完成了全系列的研发以及落地工作。
它会在发布当天, 把第一批限制数量的体验名额也同步给开放出来, 这个事儿是专门冲着内容创作者、VR开发者还有搞电商的那些人去的, 让他们能走个特殊的通道去测试一下这个新功能。
数字角色生成模型特性
交互自由度升级
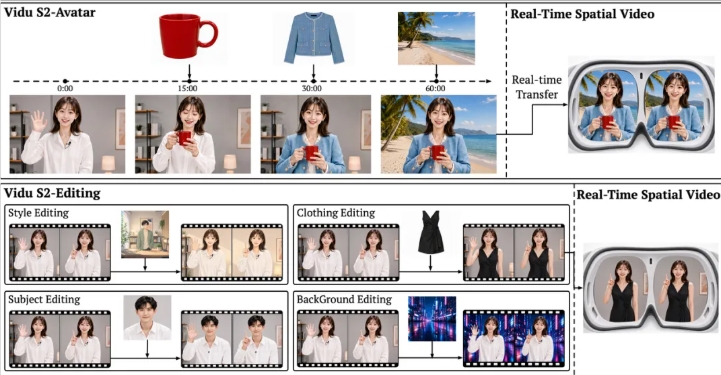
该数字角色生成模型是Vidu S2, 它实现了从基于基础的语音控制到高自由度交互方面的跨越, 用户只需要上传一张角色的图片就可以了, 通过这种方式去启动互动的流程。
用户可以给个文本或者语音的指令, 这时候模型能够很精准地把角色在说话的时候露出的那些细小表情给还原出来, 同时还能自然地把动作姿态弄好。这么做呢, 能大幅度提高那个跟着舞蹈之类比较大动作的指令去干的准确率。
动态编辑与画质提升
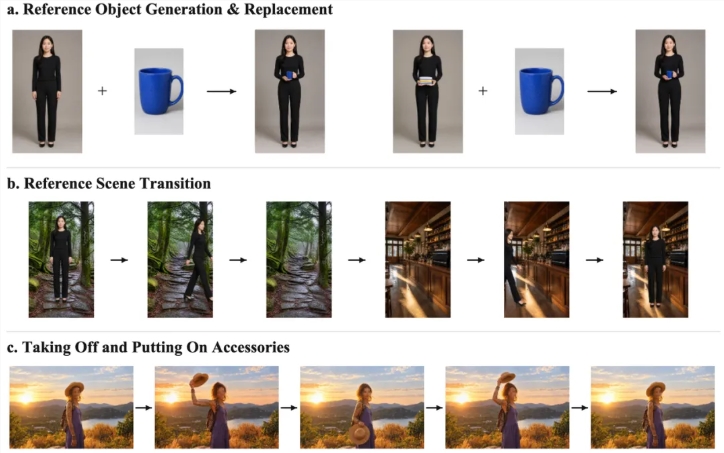
大家可以在看视频的时候, 随时上传东西, 比如物品、衣服或者背景的图片, 这样能让屏幕里的角色马上做到拿起那种指定的杯子, 或者是换上有目标的服饰, 还有切换成全新的场景这样的操作。
模型新增了视觉反馈机制, 这样能够保障连续动作衔接流畅, 同时还将实时输出分辨率从上一代的五百四十P提升至百分之七十点两K, 这让画面清晰度得到了显著优化。
实时视频流编辑功能
四大核心任务覆盖
Vidu S2视频流编辑模型是可以用来接收不停地输入的实时视频视频的, 它是依靠文本指令还有参考图去完成动态调整的, 画面上的变化可以配合人物的动作还有镜头移动的节奏。
当前这个模型能支持四种核心的任务是什么, 哪四种? 一是风格迁移, 二是虚拟试穿, 三是人物替换, 四是背景替换, 这四点都涵盖了。多数视频实时编辑场景的需求都可以被它覆盖, 目前状态就是这样。
细节处理能力优化
风格迁移这个任务, 它能够做到完整地保留人物的轮廓以及姿态, 同时也保留了场景的布局, 而且它还能同步地去调整画面的笔触与色彩, 从而呈现出各种不同的艺术效果, 这是可以做到的。
虚拟试穿这个功能, 它可以精准地去处理服装的边界, 还可以处理材质的纹理, 还能够处理好肢体之间的遮挡关系, 最终能够还原出那种真实的试穿观感。
把人物换掉这事, 是可以把人家的脸、发型这些长的啥样全都抄过来参考用的。这么做还能留着原来那段视频里人动来动去的那个样子。要是把背景给换了的时候, 人在一直动着的话, 那背景和人的相对位置是能稳住不动的。这样做就能避免那个画面突然一下跳脱出来, 不显得突兀。
VR空间视频技术探索
两类生成编辑模式
Vidu S2这个工具, 把实时生成的能力, 接入到空间视频转换的流程里, 这样做的好处是能够同时生成左眼和右眼各自的独立视图, 从而符合VR设备对于立体显示提出的需求。
还有这一种模式, 它的流程是可以先把普通的单目视频拿来做个编辑, 然后再把它转换成空间视频, 当然, 这种模式也能够直接对着那些已经存在的空间视频动刀改一改, 不管是怎么操作的这两种情况, 这四类视频编辑的任务都是可以支持的。
头显适配传输方案
生成好的空间视频内容, 能靠流式传输这个法子, 直接推到VR头显设备上。这样就不用先花时间去弄完整的文件导出再转码了。
这项技术现在已经有了一点基础, 能在大家平时消费的那些主流虚拟现实头显设备上跑起来了。它的延迟情况算是控制得比较好的, 在同行业里算是一个比较低的数值。这样一来, 它就有可能去满足那些短时间、沉浸式的互动内容所要求的实时产生的需要。
底层技术创新突破
训练方法优化升级
团队是提出了用SRF这种自回归训练的方法的, 它是先弄出了长度比较长的、能够自行生成的轨迹数据出来, 然后在这些东西里面去采样那些连续的片段进行重新加噪的操作, 以此来开展那个因果重放训练的。
这种做法能够避开因为很小的错误一点点堆积起来而产生的麻烦, 这些麻烦本来会搞出人物身份乱窜或者动作断断续续的情况, 结果就大幅度地提高了在制作很长的视频的时候画面的稳定程度。
效率与性能提升
研发团队利用那个叫作轻量级单步恢复的技术来把高分辨率细节给还原出来。另外, 他们也结合了多项调度优化技术, 目的就是要把整体计算开销尽可能降低下来。
系统实现了让各个功能模块来共享同一条时间线进行统一的调度安排。这一做法在保障画面质量没有打折的同时, 成功地单帧图像的生成所花费的时间被压缩到了百毫秒这个级别之中了。上述情况完美适应了如今对于实时场景的相关需求。
公开评测结果与未来规划
权威评测表现优异
在公开的多维度视频生成评测中, Vidu S2数字角色生成模型的表现相当不错, 这个结果显示在九项核心指标上全部取得最优成绩。
该视频编辑模型在联合评测中给出了4.26分这样高的分数, 在众多由专业方面进行的评测榜单里排到了第一的位置, 并且在如虚拟试穿这样的单项测试环节中, 超过了当时同样类型的那些模型很大的一个距离。
后续技术攻坚方向
生数科技相关负责人表示,当前空间视频技术仍处于固定视角探索阶段,距离大规模商用还有优化空间。
团队在接下来这个阶段的重点, 是要把功夫下在三个核心方面。第一个是头显端的画质要能保持得更清晰。第二个是想方设法让传输延迟进一步降下去。第三个是去探索有关全景并且能生成视频的技术。通过搞定这三大方向, 来拓展技术落地的具体场景。
你是否愿意赶在第一时间,去实际体验一下这个崭新的Vidu S2视频大模型相关产品呢, 请你务必在下面的评论区域里面把自己的观点发表出来, 同时也千万别忘了给这篇文章点个赞, 顺手把它转发给身边的人, 这样可以让你更早一点获取关于AI视频技术的各种最新动态信息。

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。