

科大讯飞推出 Spark-Audio-1.0-Preview,基于全国产算力训练的语音基座大模型,突破传统语音转文字的局限,直接理解语音内容、情绪和场景。该模型采用音频编码器搭配大语言模型,支持多任务处理,提升语音交互体验。
这款全国产化算力模型训练的语音基座大模型现已正式开放体验, 其在含高噪音等各类复杂情景下的识别能力远超同级别模型, 引发了整个行业针对AI语音入口革新的广泛相关讨论。
技术路径颠覆传统
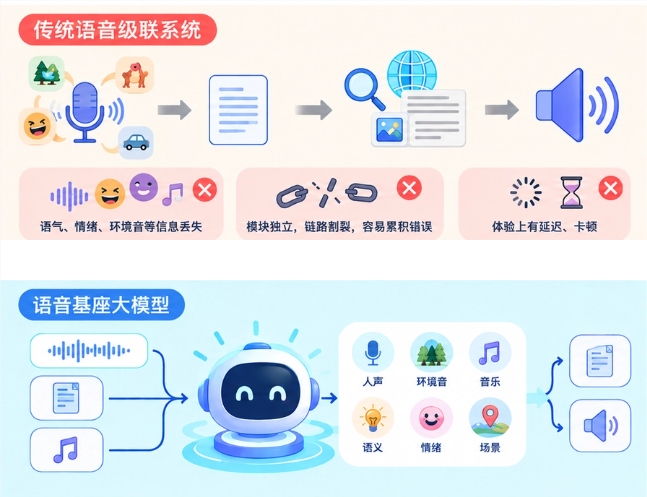
此前音频处理依赖的, 需经“转文字”衔接的多步骤方案会让语气情感逐步流失还使不同功能模块连接处容易积攒偏差累计问题。
星火-Audio-1.0直接理解语音, 一次性解析人声, 环境音及音乐, 将实现从“听清”到“听懂”的跨越。
硬件与架构细节
模型搭配30B-A3B的MoE架构采用0.65B型的Dense音频编码器大语言!
所涉训练数据, 乃含1300万小时之音频, 以及数量甚多之文本, 全部运算工作, 系全程在纯国产算力集群之基础上而完成的。
多语种识别能力
官方数据显示这模型会支持着99多种语言还有202多种方言开展着精准识别吧。
在同的尺型规对比当中它的多语多样各方言音识识别别别别别的均平效效效能能等等等等方面要要优于Qwen3.5-omni-flash模模型。
复杂场景实测
处于高噪环境与小声说话这类真实应用场景里头时候, 此款相关模型表现较之竞品要领先很多呈明显态势。
和尺寸大幅超出一个数量级的Qwen3.5-omni-plus相比, 它的整体评测得分也十分贴近。
性能短板自曝
这款讯飞的当前版本承认啦, 在通用、数学、代码这类知识及任务上, 它并没有出现明显的降智现象。
不过对在指令遵循、对话及音频理解等维度仍存有可以提升空间的之处, 以后会有针对地把欠缺部分补上去。
开放平台接入
眼下Spark-Audio-0已面向大众开放体验路径, 消减使用门槛。
API接口计划上线讯飞开放平台, 支持基于“1+N”体系微调研发适配特定场景的专用语音专属系统。
你觉着语音大模型可以完全取代传统转写工具吗? 欢迎留言分享观点, 还麻烦点赞转发支持哦。

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。