

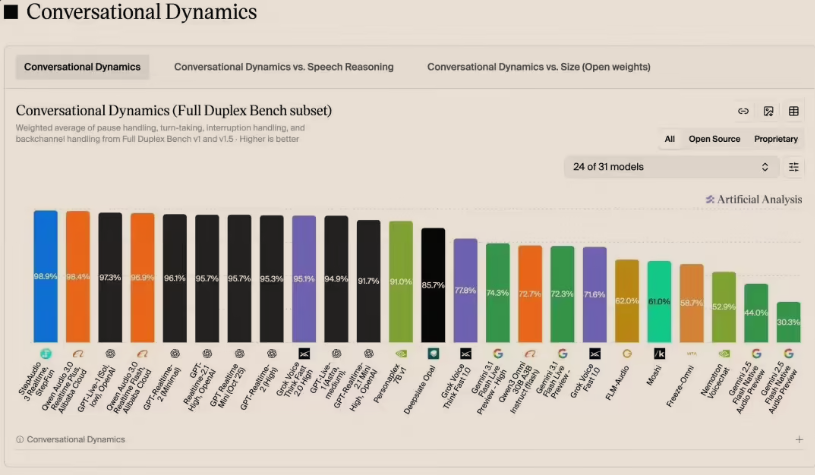
阶跃星辰于9月15日发布全新StepAudio3系列语音大模型,包含五款产品,在权威评测榜单中多款登顶全球第一。该系列面向五大应用场景,其中StepAudio3Realtime在实时交互领域表现突出,以98.9%的综合得分夺得全球第一,支持全双工原生实时对话,精准把握对话节奏,并支持多维度理解与推理。模型已在阶跃星辰开放平台全面上线。
9月15日, 阶跃星辰发布全新语音大模型矩阵, 多款产品在权威评测中登顶全球第一, 这些模型已全面开放, 覆盖实时交互、语音识别、语音生成、音频创作、音乐生成五大核心场景之上, 重塑语音AI应用边界。
实时交互双工对话
Step-Audio-Dit模型夺得全球第一, 在权威榜单中以98.9%综合得分。它处理全双工原生实时对话, 支持自然感与提升交互体验的流畅度与精准, 能显著提升临时打断与连续反馈, 懂。
该模型还达成了语义、语气及环境声音的综合理解, 通过推理与语音生成并行架构, 工具调用和长任务可异步执行, 确保语音会话永不阻塞、稳定服务复杂场景的交互支持。
语音识别精准突破
Step-Audio-ASR模型将高精度识别与大语言模型推理能力深度融合, 非流式词错误率低至1.7%, 并列全球第一, 它彻底超越了传统单纯声音转写, 实现了对语音内容的深度语义理解。
混说、方言及复杂背景音环境的中英, 该模型支持, 于医疗、法律、金融等专业领域表现优异, 就算面对低声、快语速或含糊连读等挑战, 仍能保持极高的识别准确率与稳定性。
真人级语音生成
面向实时交互的真人级语音生成模型的产品是Step-Audio-TTS, 它在音色基底、语调层次及气口停顿上贴合人类口语的状态堪称完美, 能精准还原笑声、迟疑和改口等这类副语言相关的表现。
模型根据语义内容能自主调整情绪语气, 配合流式生成架构实现生成与播放同步, 让机器语音不再机械, 而是具备高度拟人化的情感表达与节奏律动, 这种技术突破极大提升了听感舒适度。
音频内容统一生成
Step-Audio-Gen模型改变了传统音频制作的多环节冗长流程。用户仅需通过自然语言描述和参考音频, 即可一次性统一生成人声、音效、环境音及背景音, 简化了创作链路。
该模型支持对角色的音色、情绪、方言进行精细地控制, 并指定各声音元素出现的时间与它们的排布顺序。用户可直接参与整段内容的声音设计与时序编排里, 实现从创意到成品的快速转化, 进而大幅提升使用效率。
音乐创作深度建模
Step-Audio-Music模型支持基于ABC记谱法的多轮交互创制。用户可通过歌词、清唱或参照歌曲输入, 并利用自然语言直接调控曲风、乐器和情绪, 实现定制化音乐产出, 深入真实生产流程。
模型对歌曲结构及跨段落旋律展开进⾏了深层建模, 尤其在清唱无配乐场景里表现尤为卓异。仅靠一段清唱便能自主补充旋律、对位及完备编曲, 让普遍用户皆能轻松感受专业级的音乐创作与排布之喜。
开放平台全面上线
阶跃星辰公布上述五款模型已在开放平台遍及上线, 面向全球开发者与创作者开放。平台供给标准化API接口, 支持实时交互、语音识别、语音生成等五大场景的火速集成与部署, 低落开发门槛。
此次发布标志着语音AI由单点技术突破迈向全栈能力矩阵, 开发者可基于现有模型构建创新应用, 覆盖智能座舱、内容创作、在线教育等多元领域, 共同推动语音交互技术的商业化落地及产业生态的繁荣。
你觉着语音人工智能下一步会在哪些具体场景完全性颠覆传统工作流程? 欢迎在评论区分享出你的具体看法, 觉得所涉内容有价值请点赞且分享给身旁的各位科技爱好者。

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。