

DeepSeek 开放平台将于 2026 年 9 月 10 日起调整 Flash 系列模型定价,整体价格全线下调。其中,输入缓存命中价格空闲时段降至 0.02 元/百万 Token,高峰时段 0.04 元,降幅达 60%。输入缓存未命中和输出价格也相应下调,高峰时段价格翻倍。此次调整旨在优化用户体验,降低使用成本。
留心您注意, 又一轮大规模价格调整行将来袭哦。2026年9月10日正午时分, OpenAI所拥有的Flash全系列模型将会遭遇新一轮定价调整, 全线三类层级价格皆向低调校, 缓存命中下的下调幅度甚至能达到整整六成之多。
调价详情一览
那次调价定在北京时间二零二六年的九月十号的中午十二点整正式生效, 这次调改牵涉了Flash-v4-flash还有Flash-v4-flash–exp两款模型, 这两项实行一体划一的定价规格。
输入缓存命中调整后的空闲时段价格每百万Token仅需0.02元, 相比原价下降60%;输入缓存未命中调整后的空闲时段价格每百万Token降至1元, 输出调整后的空闲时段价格每百万Token降至4元。
高峰时段也打折
高峰时段的定价规则同样发生变化, 各项费用均为空闲时段的两个倍数。这意味着缓存命中的高峰价格为每百万Token零点零四元, 缓存未命中为两元, 输出为八元。
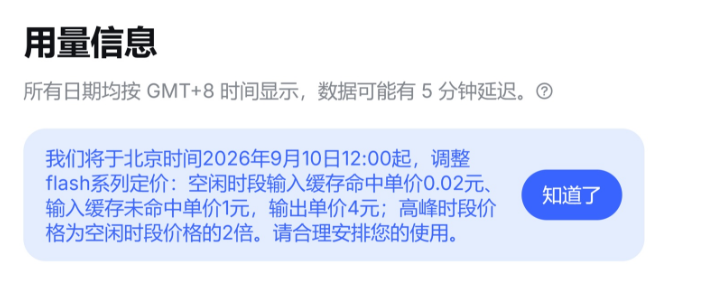
对于高频运用AI服务的企业用户来讲, 高峰时间段内的成本压力将显出减轻。以往顶峰时期颇高的调用花费, 现下下滑幅度可观, 助力企业更合宜地规划计算资源预算。
缓存命中降幅最大
从具体具体数据数据来看, 输入缓存命中的价格从空闲时段0.05元降至0.02元, 降幅达到60%, 是本次调价调价中力度最大的一项。这一变化对大量复用相同相同输入的场景尤为有利。
输入缓存未命中价格降至售价从四点五元从一点五元、降至价格降价一一点元缓存未命中, 输出由 Token 百万即便降幅里四百四十五相对价格四点五元费用、用额十而实一点元节省温和输入降幅依然可观可依然输出价。
影响范围分析
此次调价覆盖Flash系列全部现有模型, 包括正式版和实验版。对于依靠依靠依托于该系列模型开展开展展开内容生成、代码编写、数据分析等业务的开发者企业, 成本结构将得到优化优化完善。
特别是那些会处理巨量重复输入场景的应用, 像客服系统一类应用, 像文档处理一整套流程中, 缓存命中机制所带来的, 其降价效应该是更为显著的。单次被调用的成本有所下调下降60%, 这意味着同样等比预算控制下, 也能够完成更多数量的任务。
价格调整背景
要注意的是, 这是当前该平台在近期内, 在上调API价格之后, 对Flash系列商品做出的又一次定价调整。这种先提升价格之后又降低该价格的操作引发了市场的关注, 也让不少的开发者群体对后续价格的走向持观望的态度。
业内分析认为, 此番降价或与市场竞争加剧有所相关。数家AI服务商近期接连调整定价策略, 经由调低入门级模型价格以吸引更多开发者还有中小企业用户。
用户如何获益
对于普通开发者而言, Flash系列模型的低成本本在特性将进一更加凸显。以往需要谨慎管控的控制需要调用量的此前本该保守控制调用量谨言难慎使用使用的场景范围, 现在可以完全放胆放松加大力度放心地扩展原本受限的使用使用规模效用。
企业用户则可重新评估基于Flash模型的解决方案成本, 百万Token输出仅需4元的闲的时间时段价格, 使得大规模部署AI应用的经济性大幅提升, 有助于推动更多业务场景的智能化升级。
诸位开发者友友们, 此番Flash系列模型的大跌价, 会碍你现下的项目成本带来极大的冲击吗? 邀你在评论区抒发自个的看法和实际的使用感受呀!

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。