

腾讯混元团队将1.8B翻译模型压缩至几百兆大小,成功应用于B站直播弹幕实时翻译。该模型原需3.3GB内存,通过2-bit和1.25-bit量化技术,分别压缩至574MB和更小,翻译质量几乎无损,实现从Demo到高并发业务场景的跨越。
腾讯翻译模型实现重大突破
近日, 腾讯混元团队公布了一项技术成果, 这项成果引人关注, 该团队成功把旗下主打端侧的一點八B翻译模型压缩到几百兆大小的规模, 并且维持了近乎无损的翻译质量, 此成果已正式落地哔哩哔哩的直播弹幕实时翻译场景。
伴随着这一标志的产生, 意味着该模型达成了从仅仅存在于实验室Demo状态, 到能够适应高并发真实业务场景这般至关重要的跨越。在此之前, 端侧翻译模型普遍遭遇到体积过大的状况, 还面临着难以在本地流畅运行的如此这般的困境, 而此次出现的突破, 为行业供给了崭新的技术路径。
基座模型性能优异但内存占用高
有个作为技术基础的Hy-MT2-1.8B模型, 它原生支持33个语种互译。在同等尺寸模型进行对比时, 其整体翻译质量于通用翻译评测里, 已比多款商业翻译API更具优势。然而, 在传统FP16精度状况下, 该模型需要占用高达3.3GB的内存。
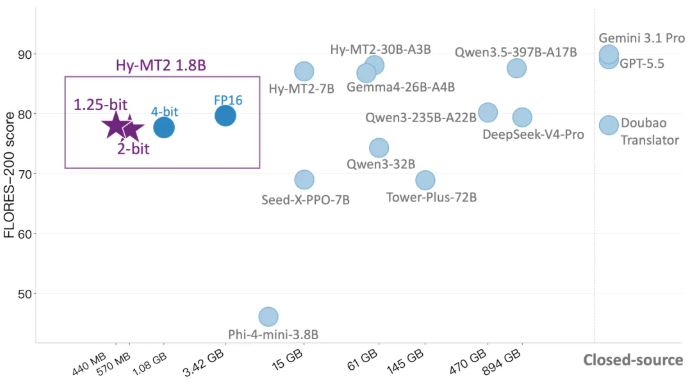
即便运用常规的4-bit量化技术, 可模型体积依旧需要1GB以上, 这一内存占用水平没办法满足端侧设备在多任务并发场景下的内存管理需求, 进而成为阻碍其落地应用的主要瓶颈, 迫切需要新的压缩方案来打破僵局。
推出两档极低比特量化方案
为应对上述内存限制情况, 腾讯推出了两档处于极低比特范畴的量化方案, 其中一档是专门面向中高端设备的2-bit模型, 该种方案运用了拉伸弹性量化技术, 进而把参数量化到特定的离散数值。
依据量化感知蒸馏方式, 此方案于把模型容量压缩到一千零五十兆字节的同时, 达成了极为近似无损的翻译水准, 也意味着用户能于有着一定先进性的设备上运行该模型, 并且无需借助云端服务就能完成具备高水准的翻译。
自研技术实现极致压缩
面向全系设备的1.25-bit极低比特方案, 属于第二档方案。该方案基于腾讯自研的稀疏高效三值量化技术, 此项技术此前已被顶级学术会议选为Oral论文。其核心策略是通过细粒度稀疏机制来实现极致压缩。
该机制让每4个参数里最为重要的3个运用特定数值进行存储, 剩余的参数被直接设置为零, 平均每个参数仅仅占据1.25-bit, 与专门为CPU设计的STQ内核相配合, 原本的3.3GB模型被极其压缩至440MB, 极大地降低了硬件门槛。
跨平台适配扩展应用场景
为使极低比特模型脱离对特定移动端 ARM 架构的依赖, 英特尔团队针对 x86 生态展开了深度适配, 团队借助对量化矩阵运算里的向量化、权重重排以及 VNNI 指令融合环节加以系统性优化, 从而显著提高了模型运行效率。
经过优化之后, Hy – MT2的那种低比特量化格式, 在英特尔的主流机型上边儿, 实现了token运行速率的显著提升。其中这些机型, 涵盖了最新的第三代酷睿Ultra以及酷睿处理器。而这一突破, 成功地把极低比特方案从移动端扩展到了PC还有边缘设备, 进而拓宽了应用范围。
B站弹幕翻译验证成功
于实际业务验证这块儿, 哔哩哔哩已把该极低比特模型正式接入直播弹幕实时翻译项目里。整套资源的下载大小大概是600MB, 运行时机内存占用维持在500到700MB这个范围之中。平均单条弹幕的翻译所花费的时间在500到800毫秒上下。
于此常规弹幕频率状况下, 该套系统依照设定能够顺畅无阻地达成实时翻译之功能, 并于此过程中表现出对各式各样网络之中流行语的精准掌控驾驭能力。此一设备以本地独立运行的模式, 一方面达成云端服务器调用所涉成本的下降以及带宽方面开销的降低功能, 另一方面于整个流程之中实现了数据上传现象的避免, 由此切实保障了用户的隐私安全。
就这种本地实时翻译的技术来看, 你持有怎样的看法? 欢迎于评论区域之中, 将你的想法给分享出来;要是感觉这篇文章具备有帮助作用的话, 那就请点赞, 并且分享给更多的朋友!

登录后参与评论
评论仅开放给已登录并完成邮箱绑定的用户。
0
暂无评论。